Распределение величины определяется не её природой, а способом, которым складываются её причины: суммой, произведением, отбором минимума или максимума.
Нормальное распределение: сумма многих малых причин
Центральная предельная теорема утверждает: сумма большого числа независимых слагаемых, ни одно из которых не преобладает над остальными, имеет приближённо нормальное распределение — независимо от того, как распределены сами слагаемые. Поэтому нормальное распределение возникает там, где величина складывается из множества мелких вкладов.
Первым такой величиной стала ошибка измерения. Гаусс в 1809 году вывел нормальный закон для ошибок астрономических наблюдений[1]: каждое наблюдение искажают дрожание воздуха, неточность прибора и реакция наблюдателя, и эти искажения складываются. В 1846 году бельгийский статистик Адольф Кетле применил тот же закон к измерениям людей — обхватам груди 5738 шотландских солдат — и показал, что их разброс описывается той же кривой, что и ошибки астрономов[2].
Рост взрослого человека определяется сотнями генов, питанием в детстве и другими факторами, вклад каждого из которых мал. В пределах одного пола рост распределён близко к нормальному закону: 68 % значений лежат в пределах одного стандартного отклонения от среднего, 95 % — двух, 99,7 % — трёх.
Отступление о смеси полов: гистограмма роста мужчин и женщин вместе не имеет двух вершин. Смесь двух нормальных распределений с одинаковым разбросом становится двухвершинной, только когда их средние отличаются больше чем на два стандартных отклонения, а разница в росте между полами меньше этого порога[3].
У нормального распределения лёгкие хвосты: значение, превышающее среднее на пять стандартных отклонений, встречается примерно один раз на 3,5 миллиона. Поэтому нормальная модель непригодна для величин, в которых крайние значения встречаются часто, — такие величины порождаются другими механизмами.
Логнормальное распределение: произведение многих причин
Если причины не складываются, а перемножаются, нормальным становится распределение логарифма величины: логарифм произведения равен сумме логарифмов, и к ней применима центральная предельная теорема. Сама величина при этом имеет логнормальное распределение — асимметричное, с длинным правым хвостом и средним больше медианы. Для экономических величин этот механизм описал Робер Жибра в 1931 году как закон пропорционального эффекта: прирост пропорционален уже достигнутому размеру[4].
Логнормально распределены инкубационные периоды инфекционных заболеваний[5], концентрации химических элементов в горных породах, численность видов в экологических сообществах, размеры частиц в осадочных породах[6]. Для размеров частиц механизм строго обосновал А. Н. Колмогоров в 1941 году: если частица многократно дробится и доля, которую составляет осколок от исходной частицы, на каждом шаге случайна и не зависит от её размера, распределение размеров стремится к логнормальному[7].
Для логнормальных данных среднее арифметическое завышает типичное значение, поэтому их описывают медианой или средним геометрическим, а разброс — мультипликативно: «в 1,5 раза больше или меньше» вместо «плюс-минус 10 единиц»[6]. Как среднее отрывается от медианы при длинном хвосте, разобрано в статье о среднем и медиане.
Распределение Пуассона: редкие независимые события
Если у события много возможностей произойти, вероятность каждой мала, а сами события независимы, их число за фиксированный интервал подчиняется распределению Пуассона. Его единственный параметр λ — среднее число событий, и дисперсия равна тому же λ.
Классический пример собрал Владислав Борткевич в книге «Закон малых чисел» (1898): число кавалеристов, погибших от удара копытом, в 10 корпусах прусской армии за 20 лет — всего 200 наблюдений «корпус-год» и 122 гибели, λ = 0,61[8].
| Гибелей за год в корпусе | Наблюдалось | Ожидается по Пуассону |
|---|---|---|
| 0 | 109 | 108,7 |
| 1 | 65 | 66,3 |
| 2 | 22 | 20,2 |
| 3 | 3 | 4,1 |
| 4 | 1 | 0,6 |
Тот же закон описывает радиоактивный распад. В 1910 году Резерфорд и Гейгер подсчитали α-частицы, испущенные препаратом полония, в 2608 интервалах по 7,5 секунды: в среднем 3,87 частицы на интервал, а частоты 0, 1, 2… частиц совпали с распределением Пуассона[9]. По тому же принципу моделируются голы в хоккее — этому посвящена статья о статистике хоккея.
Равенство дисперсии и среднего служит проверкой модели. Если дисперсия числа событий заметно больше среднего, события не независимы: случаи заболевания при эпидемии, отказы оборудования из-за общей причины и другие события, которые возникают группами.
Экспоненциальное распределение: время ожидания
Если события наступают по закону Пуассона, время между ними распределено экспоненциально. Главное свойство этого распределения — отсутствие памяти: вероятность того, что событие наступит в ближайшую минуту, не зависит от того, сколько времени уже прошло.
Радиоактивное ядро не стареет. Вероятность его распада в течение ближайшего года одинакова для ядра, образовавшегося вчера и миллион лет назад, поэтому время жизни ядра распределено экспоненциально, а количество нераспавшихся ядер убывает вдвое за каждый период полураспада. Для углерода-14 этот период составляет около 5730 лет[10]: за 11 460 лет остаётся четверть исходного количества, на чём основан радиоуглеродный метод датирования.
Живые организмы, напротив, стареют. Бенджамин Гомперц в 1825 году установил, что смертность взрослого человека растёт с возрастом экспоненциально[11], поэтому продолжительность жизни не подчиняется экспоненциальному закону.
Экстремальные значения: слабейшее звено и сильнейший паводок
Многие величины определяются не суммой, а крайним значением из множества: прочность цепи — самым слабым звеном, уровень реки за год — самым сильным паводком. Для таких величин действует аналог центральной предельной теоремы — теорема Фишера — Типпета — Гнеденко. Максимум большого числа независимых одинаково распределённых величин после нормировки может иметь только одно из трёх предельных распределений: Гумбеля, Фреше или Вейбулла[12][13]. Для минимума справедливо то же самое.
Распределение Вейбулла
Шведский инженер Валодди Вейбулл вывел распределение для прочности материалов из модели слабейшего звена: образец разрушается там, где находится его самый слабый участок[14]. Позднее распределение Вейбулла стало основной моделью времени до отказа в теории надёжности. Его параметр формы k описывает, как интенсивность отказов меняется со временем:
- k < 1 — интенсивность отказов снижается: отсеиваются изделия с производственными дефектами;
- k = 1 — интенсивность постоянна, распределение совпадает с экспоненциальным: отказы случайны;
- k > 1 — интенсивность растёт: изделие изнашивается.
Последовательность этих трёх периодов в жизни изделия образует U-образную кривую интенсивности отказов. Распределением Вейбулла описывают и скорость ветра: стандарт проектирования ветроустановок IEC 61400-1 использует его частный случай с k = 2 — распределение Рэлея[15].
Распределение Гумбеля
Эмиль Гумбель применил теорию экстремальных значений к гидрологии: годовые максимумы расхода воды в реках и суточных осадков хорошо описываются распределением, которое теперь носит его имя[13]. По этому распределению рассчитывают высоту дамб и мостов.
Из той же теории происходит понятие «паводок раз в 100 лет». Оно означает
не периодичность, а вероятность 1 % в каждый отдельный год. Вероятность
хотя бы одного такого паводка за n лет равна
1 − 0,99ⁿ: за 10 лет — 9,6 %,
за 30 лет — 26,0 %, за 100 лет — 63,4 %. Для дома, построенного
в зоне столетнего паводка, вероятность хотя бы одного затопления за 30 лет
составляет больше четверти.
Степенной закон: преимущество накапливается
Величина подчиняется степенному закону, если доля значений больше x убывает
как x−α. Такое
распределение не имеет характерного масштаба: доля значений, которые
вдвое больше заданного, одинакова для любого x. На графике в двойном
логарифмическом масштабе степенной закон изображается прямой линией
с наклоном −α.
Примеры степенных законов в природе и обществе[16]:
- Землетрясения — закон Гутенберга — Рихтера: с ростом магнитуды на единицу число землетрясений уменьшается примерно в 10 раз[17], а выделяемая энергия растёт примерно в 32 раза.
- Частоты слов — закон Ципфа: частота слова обратно пропорциональна его рангу в списке по частоте. Второе по частоте слово встречается примерно вдвое реже первого, третье — втрое[18].
- Размеры городов подчиняются тому же закону Ципфа применительно к численности населения[18].
- Доходы и богатство — Вильфредо Парето в 1896 году обнаружил степенной закон в распределении доходов[19]. Принцип 80/20 соответствует показателю α ≈ 1,16: при нём 20 % крупнейших значений составляют 80 % суммы.
- Размеры лунных кратеров, энергия солнечных вспышек, площади лесных пожаров[16].
Основной механизм степенных законов — предпочтительное присоединение: новый элемент с большей вероятностью достаётся тому, у кого уже больше. Новый житель выбирает крупный город, потому что там больше работы; новая статья чаще цитирует уже известную. Герберт Саймон формализовал этот механизм в 1955 году[20], Альберт-Ласло Барабаши и Река Альберт применили его к росту сетей, включая интернет, в 1999 году[21]. Для землетрясений и лесных пожаров предложен другой механизм — самоорганизованная критичность: система накапливает напряжение до порога, а разрядка запускает каскад произвольного размера[22].
При α ≤ 2 дисперсия степенного распределения бесконечна, при α ≤ 1 бесконечно и среднее. На практике это означает, что выборочное среднее не стабилизируется с ростом выборки: каждое новое экстремальное значение сдвигает его заметнее, чем все предыдущие наблюдения вместе[16].
Прямая линия на графике в двойном логарифмическом масштабе ещё не доказывает степенной закон. Аарон Клаузет, Косма Шализи и Марк Ньюман проверили 24 набора данных, для которых в литературе заявлялся степенной закон, методом максимального правдоподобия и статистическими тестами. Для части из них гипотеза была отвергнута, а для многих логнормальное распределение описывало данные не хуже степенного[23].
Закон Бенфорда
В 1881 году астроном Саймон Ньюком заметил, что первые страницы таблиц
логарифмов, где находятся числа, начинающиеся с единицы, изношены сильнее
последних[24]. В 1938 году физик Фрэнк
Бенфорд проверил это наблюдение на 20 229 числах из 20 источников —
площадях рек, численности населения, физических константах, молекулярных
массах — и получил закон: первая значащая цифра d встречается с вероятностью
lg(1 + 1/d)[25].
Единица стоит первой в 30,1 % чисел, девятка — в 4,6 %.
Закон выполняется для величин, значения которых распределены на несколько порядков: логнормальных с большим разбросом и степенных. Для узкого нормального распределения он неприменим: рост взрослых людей в сантиметрах почти всегда начинается с единицы. Проверка на смоделированных данных:
| Первая цифра | Закон Бенфорда | Логнормальное, σ = 3 | Логнормальное, σ ≈ 0,9 | Нормальное |
|---|---|---|---|---|
| 1 | 30,1 % | 29,8 % | 30,3 % | 0,7 % |
| 2 | 17,6 % | 17,7 % | 19,2 % | 98,6 % |
| 3 | 12,5 % | 12,5 % | 13,1 % | 0,7 % |
| 5 | 7,9 % | 7,9 % | 7,6 % | 0,0 % |
| 9 | 4,6 % | 4,5 % | 4,3 % | 0,0 % |
Чем шире разброс логнормальных данных, тем точнее выполняется закон; сумма 50 случайных чисел со средним 25 и стандартным отклонением 2 почти всегда начинается с двойки. Закон Бенфорда применяют в аудите: в бухгалтерских данных, придуманных человеком, частоты первых цифр обычно отклоняются от закона[26].
Проверка моделированием
Каждый механизм можно воспроизвести, не задавая распределение результата явно. В коде ниже величины порождаются только операциями — сложением, умножением, подсчётом редких событий, выбором минимума и максимума, — а подходящее распределение затем подбирается к результату.
Скачать Jupyter Notebook Открыть в Google Colab
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats

sns.set_theme(style='whitegrid')
rng = np.random.default_rng(42)

n_samples = 20_000

# 1. Сумма 50 независимых факторов
sums = rng.uniform(0, 1, size=(n_samples, 50)).sum(axis=1)

# 2. Произведение 50 независимых множителей от 0,8 до 1,25
products = rng.uniform(0.8, 1.25, size=(n_samples, 50)).prod(axis=1)

# 3. Число редких событий: 1000 испытаний с вероятностью 0,003
counts = rng.binomial(1000, 0.003, size=n_samples)

# 4. Время ожидания первого события при вероятности 0,01 на шаг
waits = rng.geometric(0.01, size=n_samples)

# 5. Прочность цепи из 50 звеньев — минимум прочностей звеньев
minima = rng.gamma(shape=3, scale=1, size=(n_samples, 50)).min(axis=1)

# 6. Годовой максимум суточных осадков — максимум из 365 значений
maxima = rng.exponential(scale=5, size=(n_samples, 365)).max(axis=1)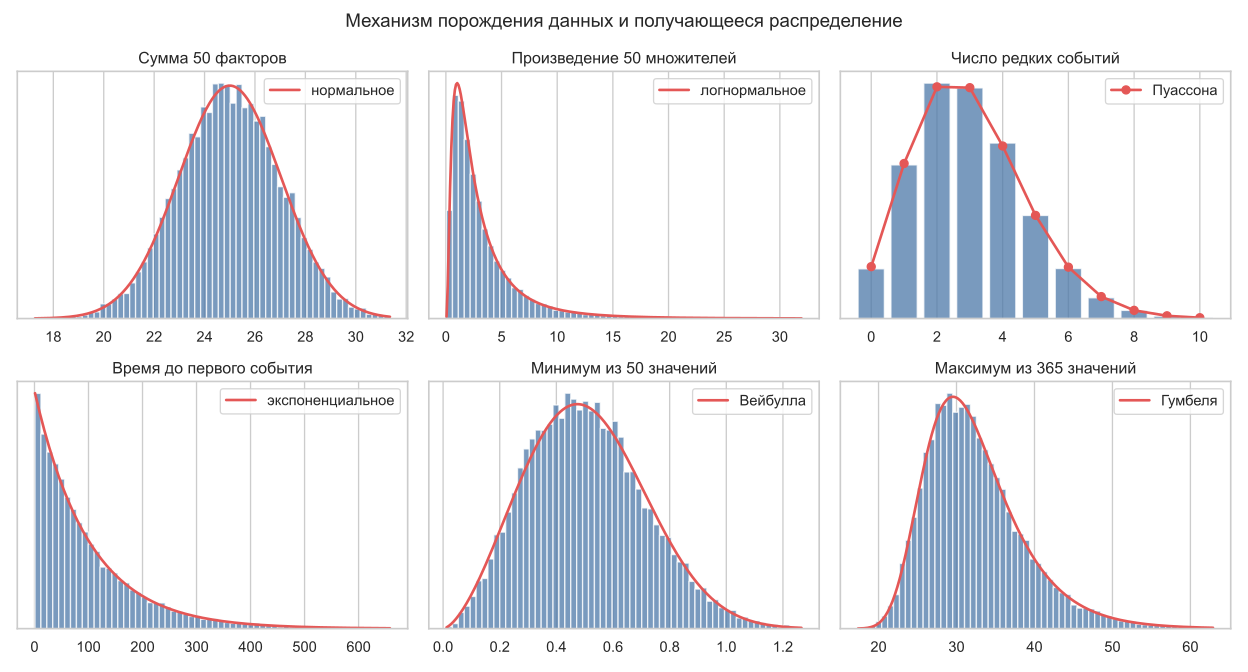
Исходные величины в примерах распределены равномерно, экспоненциально или по гамма-закону, однако результат определяется операцией, а не исходным распределением. Код построения графиков приведён в ноутбуке.
Степенной закон воспроизводится моделью Саймона: каждый новый житель с вероятностью 0,2 основывает новый город, а в остальных случаях переселяется в город случайно выбранного жителя. Вероятность попасть в город пропорциональна его размеру, то есть крупные города растут быстрее.
n_people = 500_000
p_new_city = 0.2

city_of = np.empty(n_people, dtype=np.int64)
city_of[0] = 0
n_cities = 1
coins = rng.random(n_people)
picks = rng.random(n_people)

for t in range(1, n_people):
    if coins[t] < p_new_city:
        city_of[t] = n_cities
        n_cities += 1
    else:
        city_of[t] = city_of[int(picks[t] * t)]

city_sizes = np.bincount(city_of)
print(f'Городов: {n_cities}, крупнейший: {city_sizes.max()} жителей, '
      f'городов из одного жителя: {(city_sizes == 1).mean():.0%}')
Городов: 100179, крупнейший: 48969 жителей, городов из одного жителя: 55%
Сравним три выборки — нормальную, логнормальную и степенную — по отношению среднего к медиане и по доле суммы, которая приходится на 1 % крупнейших значений:
def top_share(values, share=0.01):
    values = np.sort(values)[::-1]
    top = values[:max(1, int(len(values) * share))]
    return top.sum() / values.sum()

samples = {
    'Сумма (нормальное)': sums,
    'Произведение (логнормальное)': products,
    'Размер города (степенное)': city_sizes,
}

print(f'{"Выборка":30s} {"Среднее/медиана":>16s} {"Доля 1 % крупнейших":>20s}')
for name, values in samples.items():
    print(f'{name:30s} {values.mean() / np.median(values):16.2f} '
          f'{top_share(values):20.1%}')
Выборка Среднее/медиана Доля 1 % крупнейших Сумма (нормальное) 1.00 1.2% Произведение (логнормальное) 1.48 7.2% Размер города (степенное) 4.99 43.7%
В нормальной выборке 1 % крупнейших значений даёт 1,2 % суммы — почти столько же, сколько любой другой процент. В логнормальной — 7,2 %, в степенной — 43,7 %: в 1 % крупнейших городов живёт почти половина всех жителей модели.
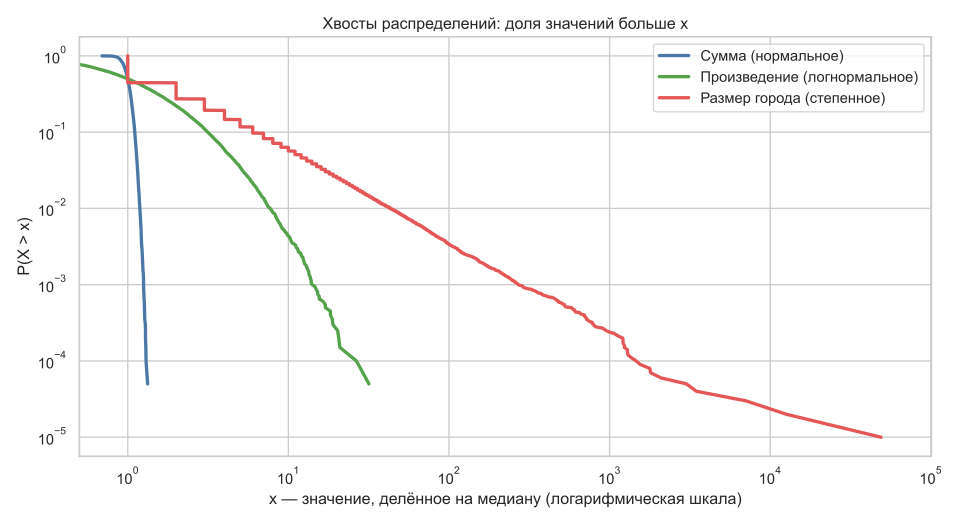
Значение, в 10 раз превышающее медиану, в нормальной выборке не встречается ни разу, в логнормальной — в 0,4 % случаев, в степенной — в 5,7 %. Степенной хвост на графике близок к прямой, логнормальный изгибается вниз.
Как определить распределение по данным
- Механизм. Прежде чем подбирать распределение, следует определить, как возникает величина: складываются ли причины, перемножаются, считаются ли события, выбирается ли крайнее значение.
- Гистограмма в логарифмической шкале. Если гистограмма логарифмов симметрична, распределение близко к логнормальному.
- Дисперсия и среднее счётных данных. Для распределения Пуассона они равны; дисперсия, заметно превышающая среднее, указывает на зависимость событий.
- Доля значений больше x в двойном логарифмическом масштабе. Прямая линия согласуется со степенным законом, изгиб вниз — с логнормальным распределением. Окончательный вывод требует статистического теста[23].
- Квантиль-квантильный график (Q-Q plot). Точки на прямой означают согласие с проверяемым распределением, отклонения на концах — расхождение в хвостах.
Сводная таблица
| Механизм | Распределение | Примеры | Описательные статистики |
|---|---|---|---|
| Сумма многих независимых причин | Нормальное | Рост, ошибки измерений | Среднее и стандартное отклонение |
| Произведение многих независимых причин | Логнормальное | Инкубационные периоды, размеры частиц, концентрации элементов | Медиана или среднее геометрическое, мультипликативный разброс |
| Число редких независимых событий | Пуассона | Радиоактивный распад, несчастные случаи | Среднее число событий λ |
| Время до события без старения | Экспоненциальное | Время жизни радиоактивного ядра | Среднее время или период полураспада |
| Минимум из многих величин | Вейбулла | Прочность материалов, время до отказа | Параметры формы и масштаба |
| Максимум из многих величин | Гумбеля | Годовые максимумы паводков и осадков | Уровень, превышаемый раз в N лет |
| Накопление преимущества, каскады | Степенное | Землетрясения, города, частоты слов, доходы | Показатель α и квантили; среднее неустойчиво |
Вывод
Ошибка в выборе распределения сильнее всего сказывается на крайних значениях. Нормальная модель, подобранная к данным со степенным хвостом, может совпадать с ними в центре и при этом занижать вероятность значений, в десятки раз превышающих медиану, на порядки. Поэтому расчёт рисков — паводков, отказов, землетрясений — начинается с вопроса о механизме, который порождает величину.
Источники
- Gauss C. F. Theoria motus corporum coelestium in sectionibus conicis solem ambientium. — Hamburg, 1809.
- Stigler S. M. The History of Statistics: The Measurement of Uncertainty before 1900. — Harvard University Press, 1986.
- Schilling M. F., Watkins A. E., Watkins W. Is Human Height Bimodal? // The American Statistician. — 2002. — Vol. 56, No. 3. — P. 223–229.
- Gibrat R. Les Inégalités économiques. — Paris, 1931.
- Sartwell P. E. The Distribution of Incubation Periods of Infectious Disease // American Journal of Hygiene. — 1950. — Vol. 51. — P. 310–318.
- Limpert E., Stahel W. A., Abbt M. Log-normal Distributions across the Sciences: Keys and Clues // BioScience. — 2001. — Vol. 51, No. 5. — P. 341–352.
- Колмогоров А. Н. О логарифмически нормальном законе распределения размеров частиц при дроблении // Доклады АН СССР. — 1941. — Т. 31, № 2. — С. 99–101.
- Bortkiewicz L. Das Gesetz der kleinen Zahlen. — Leipzig, 1898.
- Rutherford E., Geiger H. The Probability Variations in the Distribution of α Particles // Philosophical Magazine. — 1910. — Vol. 20. — P. 698–707.
- Godwin H. Half-life of Radiocarbon // Nature. — 1962. — Vol. 195. — P. 984.
- Gompertz B. On the Nature of the Function Expressive of the Law of Human Mortality // Philosophical Transactions of the Royal Society of London. — 1825. — Vol. 115. — P. 513–583.
- Fisher R. A., Tippett L. H. C. Limiting Forms of the Frequency Distribution of the Largest or Smallest Member of a Sample // Proceedings of the Cambridge Philosophical Society. — 1928. — Vol. 24, No. 2. — P. 180–190. Строгое доказательство: Gnedenko B. Sur la distribution limite du terme maximum d'une série aléatoire // Annals of Mathematics. — 1943. — Vol. 44, No. 3. — P. 423–453.
- Gumbel E. J. Statistics of Extremes. — Columbia University Press, 1958.
- Weibull W. A Statistical Distribution Function of Wide Applicability // Journal of Applied Mechanics. — 1951. — Vol. 18. — P. 293–297.
- IEC 61400-1:2019. Wind energy generation systems — Part 1: Design requirements.
- Newman M. E. J. Power Laws, Pareto Distributions and Zipf's Law // Contemporary Physics. — 2005. — Vol. 46, No. 5. — P. 323–351.
- Gutenberg B., Richter C. F. Frequency of Earthquakes in California // Bulletin of the Seismological Society of America. — 1944. — Vol. 34, No. 4. — P. 185–188.
- Zipf G. K. Human Behavior and the Principle of Least Effort. — 1949.
- Pareto V. Cours d'économie politique. — Lausanne, 1896–1897.
- Simon H. A. On a Class of Skew Distribution Functions // Biometrika. — 1955. — Vol. 42, No. 3/4. — P. 425–440.
- Barabási A.-L., Albert R. Emergence of Scaling in Random Networks // Science. — 1999. — Vol. 286, No. 5439. — P. 509–512.
- Bak P., Tang C., Wiesenfeld K. Self-Organized Criticality: An Explanation of the 1/f Noise // Physical Review Letters. — 1987. — Vol. 59, No. 4. — P. 381–384.
- Clauset A., Shalizi C. R., Newman M. E. J. Power-Law Distributions in Empirical Data // SIAM Review. — 2009. — Vol. 51, No. 4. — P. 661–703.
- Newcomb S. Note on the Frequency of Use of the Different Digits in Natural Numbers // American Journal of Mathematics. — 1881. — Vol. 4, No. 1. — P. 39–40.
- Benford F. The Law of Anomalous Numbers // Proceedings of the American Philosophical Society. — 1938. — Vol. 78, No. 4. — P. 551–572.
- Nigrini M. J. Benford's Law: Applications for Forensic Accounting, Auditing, and Fraud Detection. — Wiley, 2012.